oct_extract.py — construction du script, pas à pas
Comment le script d'extraction OCT est construit, brique par brique : les librairies, le filtrage par SOP Class UID, la récupération des tags avec getattr, le formatage du PatientName, puis l'écriture CSV et la conversion Excel.
- DICOM
- pydicom
- OCT
- Python
- Automatisation
OK, donc script écrit en Python, parce que la librairie la plus popularisée pour DICOM est sans aucun doute pydicom.
Pour le MVP je reste mono-fichier mais je m'autorise à un schéma d'itération pour une exécution sur tout un dossier !
On attaque avec les librairies :
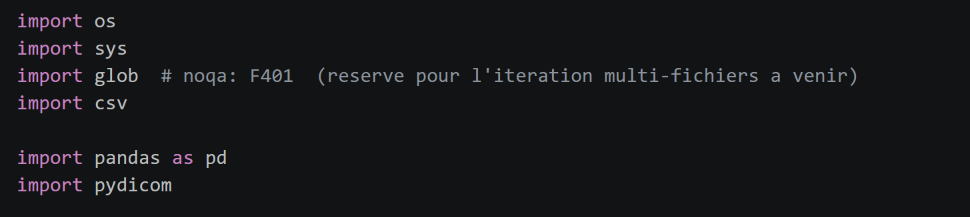
Donc os, sys, glob comme tout bon script qui se respecte pour l'interaction avec l'OS, la gestion / recherche fichier ; csv pour du CSV writing ici, pandas je ne connaissais pas, c'est une librairie pour de la conversion csv to Excel, ça m'a bien économisé des lignes c'est cool !
Et Pydicom évidemment pour les manips DICOM, ce qui va me permettre de t'expliquer plus en détail l'architecture DICOM !!
Bon tout à l'heure je parlais de méta-datas. Pour être plus précis, un fichier DICOM c'est un dictionnaire au sens programmatif du terme en fait. Une clé, une valeur. En DICOM, ça donne ça :
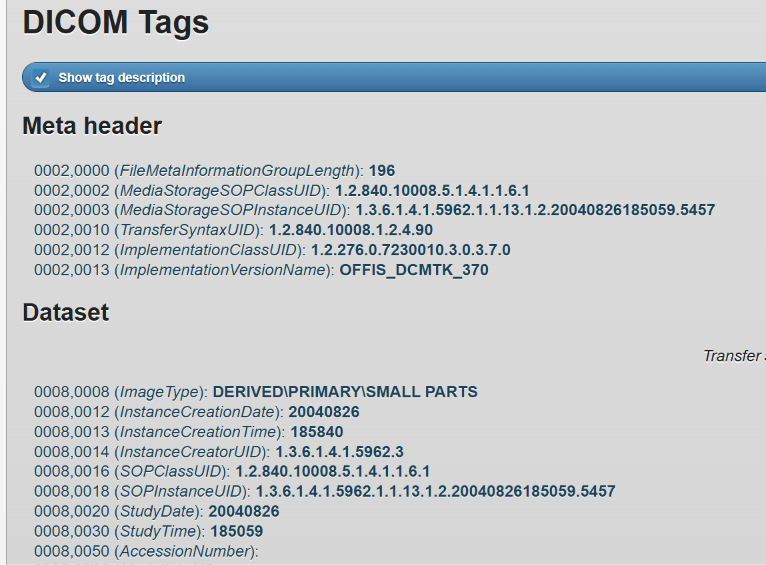
(Groupe Number, Element Number) Value Representation : Valeur prise
Sur la toute première ligne, (0002, 0000) sont les 4 octets qui identifient la méta-donnée FileMetaInformationGroupLenght (qu'on appelle une Value Representation, VR). Et la valeur prise par cette VR c'est 196. J'ai mis quelques jours pour m'approprier la nomenclature, c'est normal que ça paraisse « lourd » au début. Après quand c'est maîtrisé c'est vraiment cool.
Tu vois le tag 0008, 0016 (SOPClass UID) : 1.3.6….5457 ? Ça c'est un SOP Class UID donc, un identifiant de Service-Object-Pair donc. Ça veut dire quoi ??
Un objet, c'est un scanner, un écho, une OCT, une radio … C'est un élément d'imagerie référencé parmi ceux de la liste de DICOM.
Et un service c'est une manipulation de cet objet : le déplacer d'une machine à une autre, le stocker dans le PACS, le chercher dans le PACS depuis ton PC …
Donc quand tu dis « Stockage d'une OCT », c'est une action bien définie et bien identifiée par son SOPClass UID, cette longue série de chiffres.
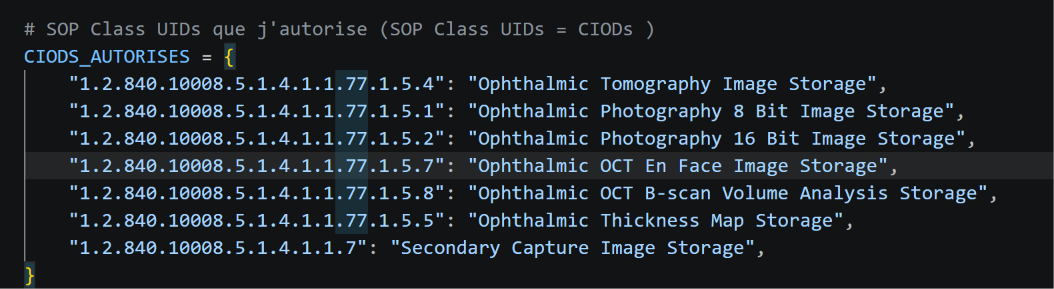
Eh bien la première étape du script, c'est n'autoriser que certains examens à rentrer dans le pipeline du script. L'idée derrière, c'est que pour Laterality par exemple, si l'user exécute le script avec un CT scan, il n'y aura pas de tag Laterality dans la structure du fichier CT. Et donc ça va planter. Donc ça me permet d'expliquer les plantages à un user qui n'a pas l'utilisation adaptée.
Donc concrètement je crée un dictionnaire des SOP Class UID que j'autorise à entrer.
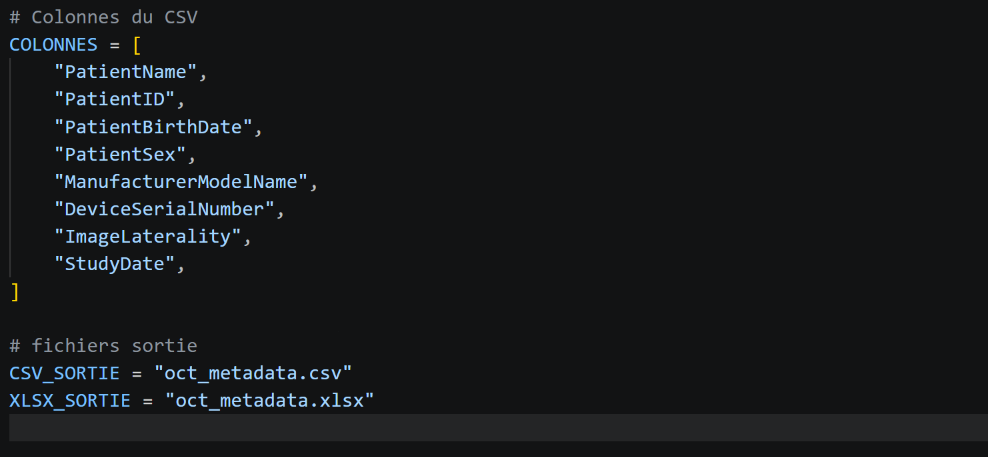
Ensuite définis donc mes colonnes CSV (l'idée : en colonne les metadatas, et un .dcm par ligne), et les fichiers de sortie (les output du script).
Ensuite, la récupération des attributs : j'utilise la fonction getattr () au lieu d'un habituel ds.[Attribut] ; de cette façon, si j'ai un attribut vide, le script ne plante pas (ce qu'il aurait fait, si le ds.[Attribut] est vide). Donc je peux spécifier un fallback vide en cas de no return. C'est cool je connaissais pas ce getattr. On apprend vraiment vite avec Claude, c'est dingue. (Après en principe, tous les tags que j'ai spécifiés dans le script sont de type 1, c'est-à-dire obligatoirement présents dans le fichier donc ..)
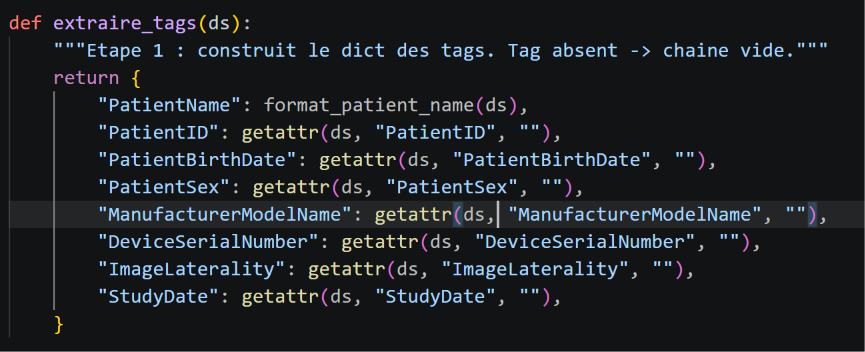
J'explique la fonction format_patient_name : tu as les noms et prénoms séparés par un « ^ ». Donc pour faire joli voici format_patient_name (et pour introduire un joli concept de Pydicom) :
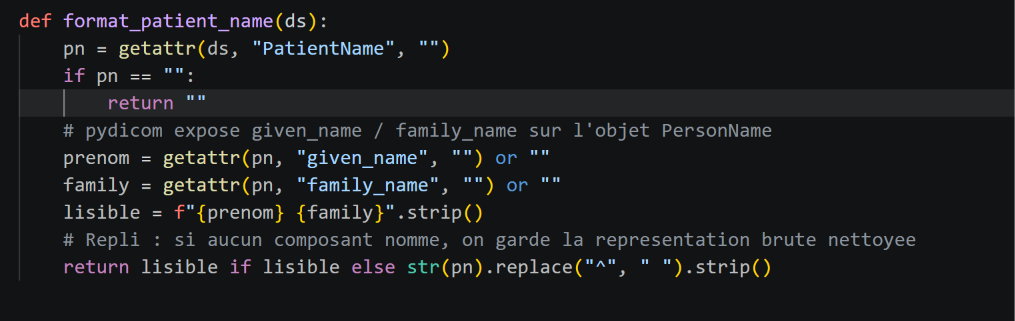
En fait le tag PatientName est intelligemment analysé par Pydicom comme un nom et prénom ! Les sous-attributs given_name et family_name sont respectivement le nom et le prénom. Ensuite, je rends tout ça lisible (strip() pour enlever les espaces/tabulations surnuméraires ; f pour FormatString). Et en bas, l'if return : si lisible n'est pas vide, on le return, sinon, on string pn (le PatientName vide donc) avec un replace ^ et un effacement des tabulations !
Ensuite l'écriture du fichier CSV puis la conversion Excel :
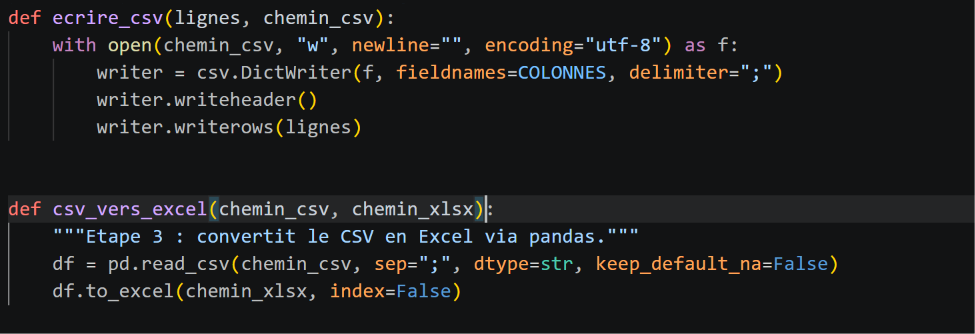
Je crée l'objet writer avec la classe DictWriter, au vu de la structure dictionnaire des datas. Mes fieldnames sont donc mes colonnes définies plus haut, le délimiteur est un « ; » (classique). J'utilise les méthodes writeheader et writerows pour générer mon csv et voilà !
Ensuite bon j'ai suivi la docu pandas (pandas as pd). Il faut faire un read_csv pour écrire un fichier temporaire puis avec la méthode to_excel j'écris mon .xlsx.
Et on est parti pour l'orchestration de tout ça !
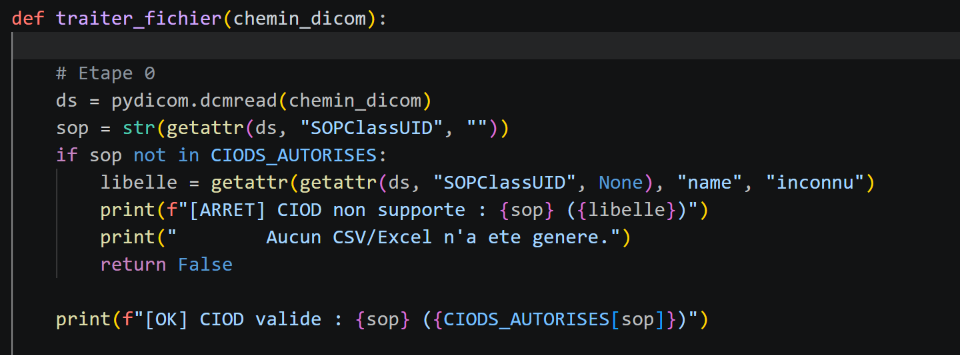
Je crée la fonction métier traiter_fichier :
-
(quand t'oublies de créer l'étape 1 dans ton plan et que tu reviens dessus haha). C'est là que j'utilise la fameuse classe dcmread qui vient lire le DICOM et stocker les tags dans l'objet ds, utilisé tout du long. Je viens ensuite comparer l'attribut SOPClass UID avec la liste des CIODs autorisés, et s'il y est contenu, on déroule le script (comme expliqué plus haut).
-
On déroule ensuite les fonctions extraire_tags, écrire_csv et csv_vers_excel ;
Et enfin, le passage de l'argument (le fichier DICOM en question) :
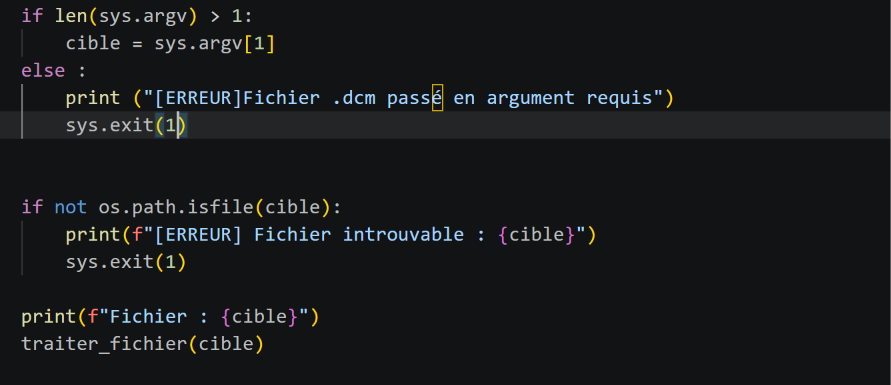
Je requiers un argument pour l'exécution du script (le fichier dcm en question). J'utilise os.path.isfile pour aller chercher le path relatif, et je force le passage d'argument.
Si tout est bon, on exécute la fonction métier sur la variable cible, à savoir le path du fichier DICOM !!
Le rendu final :
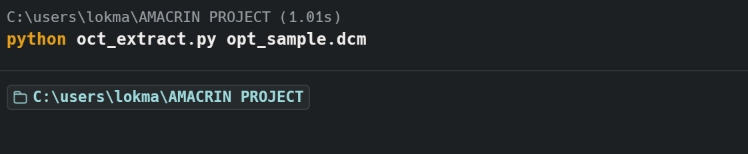
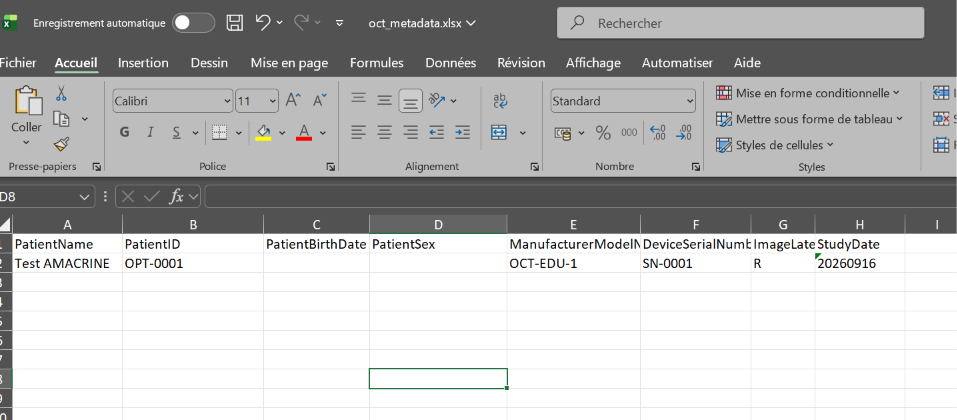
Télécharger l'outil
- PYTélécharger
oct_extract.py — construction du script, pas à pas
4,6 Ko
Article d'origine
Du PACS au fichier Excel en 30 secondes
Lire le numéro →